

科技日报记者 罗云鹏
日前,中电信人工智能科技有限公司发布星辰大模型Xing4.0-29B-A4B,冲进国际开源AI模型社区Hugging Face趋势榜前四。
据悉,这款总参数29B、激活参数仅4B的模型,全流程训练在国产昇腾910C集群上完成,一张消费级显卡即可本地运行。
轻量化先算一笔账。传统同量级29B模型以FP16精度部署,显存需求约60GB,离不开多卡高端服务器。
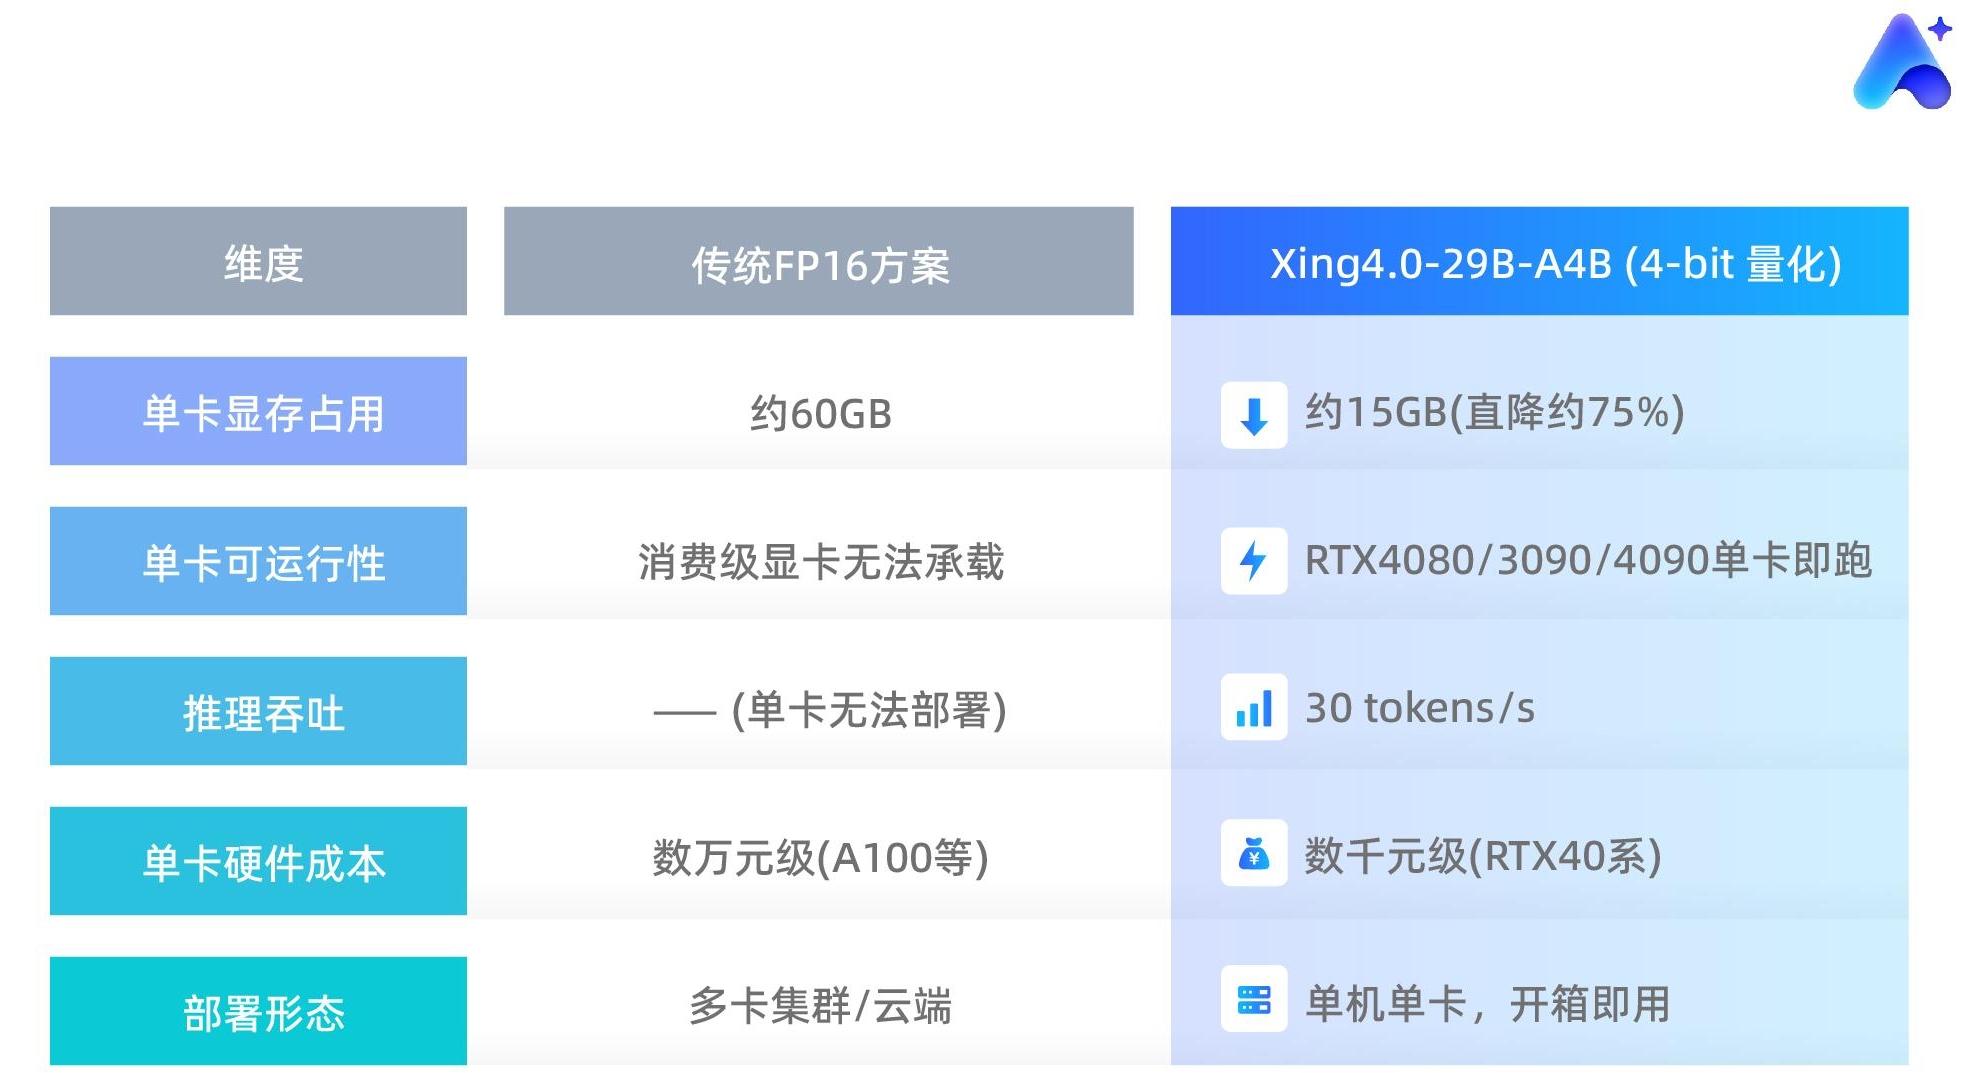
数据显示,Xing4.0-29B-A4B经4-bit量化后,单卡显存占用压缩至约15GB,开销直降75%,且可在RTX 3090、4090等24GB显卡,支持长上下文Agent任务,推理吞吐可达30tokens/s。
记者注意到,轻量化的核心不是压缩参数,而是砍掉无效算力。
研发团队依托MoE架构,针对64路由专家、Top4激活场景,通过专家负载均衡、Grouped GEMM、通信与计算重叠等手段化解瓶颈,再叠加选择性重计算和mHC定制融合算子,训练吞吐较开箱原始性能提升96%,接近翻倍。
算力提效之外,更关键的是全栈国产。该模型从研发源头锚定国产软硬件栈,基于MindSpore/MindFormers框架对mHC多残差连接架构深度定制,配套开发专属融合算子,打通架构、编译、算子到硬件的全链路。
以往,轻量模型常有一块短板:长会话逻辑断裂、多步规划失效、工具调用不稳。Xing4.0-29B-A4B采用面向Agent定制的mHC+MLA+MTP架构,强化多步规划与长链路推理。
评测数据给出印证。其在SWE-bench Verified取得75.0分,逼近Qwen3.6-35B-A3B的76.0分,大幅领先Gemma4-26B-A4B;Terminal-Bench 2.1得分57.5,Claw-Eval得分76.55,均优于同级模型。
评测之外,还需真实场景验证。目前,该模型已在集团客服智能体场景完成私有化部署。
例如,运营商热线覆盖套餐变更、账单查询、故障报修等数十类高频业务,用户通话数据与业务记录全程不出域,模型沿“意图理解—任务拆解—工具调用—结果整合—合规校验”链路自主办理,首Token响应时延显著压降,支撑热线“边说边响应”。
而对开发者而言,这意味着无须高额算力投入,本地即可完成智能体原型开发与调试,中小团队私有化部署和边缘端应用也有了可选的国产基座。
目前,该模型已同步上架GitHub、HuggingFace、魔搭、Gitee、魔乐五大社区,跑通第一个本地智能体的门槛,已降到一张消费级显卡。
(受访单位供图)
 网友评论