

科技日报记者 付丽丽
“大多数日常工作,已经用不着最顶尖的云端大模型。”在近期举行的一场谷歌开发者社区技术大会上,电气与电子工程师协会(IEEE)高级会员程路给出了一个与“参数竞赛”背道而驰的判断:一个能装进普通电脑的小模型,已经足以把不少真实任务做好。他的分享主题不是“怎么把模型做得更大”,而是“怎么把模型放回自己电脑上跑”。
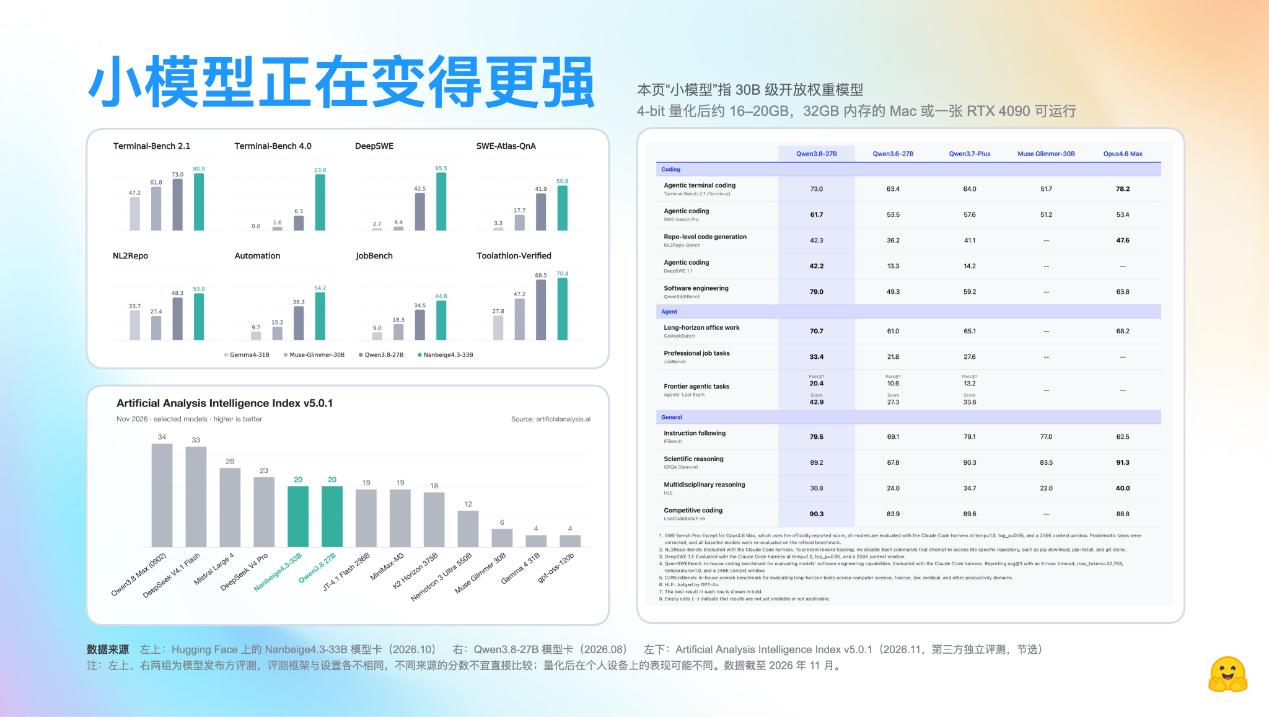
过去,AI能力几乎与参数规模画等号。程路举了一组对照:通义千问两代模型参数都在270亿左右,但在让模型自主读文件、执行命令、逐步完成任务的测试中,成绩从63.4分升至73分。“参数规模差不多,能力却在往上走。模型进步,并不只靠越做越大。”
第三方数据提供了更直接的佐证。有独立评测机构公布的智能指数显示,30B级的Qwen3.8-27B与Nanbeige4.3-33B都拿到20分,而参数量高达数千亿的DeepSeek V4.1 Flash也不过33分。程路同时提醒,厂商自测成绩不能直接等同于本地实跑效果,但方向已经清楚:“聪明”不再必然等于“昂贵”和“必须上云”。
程路首先厘清了一组被混用的概念:“开放”只意味着模型可以下载,“本地”则要求它真能装进普通人的设备。他所说的“小模型”,指300亿参数左右的开放模型,经过量化压缩后约需16至20GB内存,一台32GB内存的Mac或一张RTX 4090即可运行;更小的20亿参数模型只占2到3GB内存。
程路从一份内部会议记录讲起,想把待办事项整理出来,却不愿为此把原文发到外部服务。本地AI解决的不是“能不能做得更好”,而是“数据出不出门、断网能不能用、明天这个模型还在不在”。“今天用得顺手的模型,明天不一定还在。”账单焦虑同样被消解:想跑多久就跑多久,没有意外使用费。
面对层出不穷的小模型,程路的建议很朴素:先写清楚任务,再挑两三个候选,用十封有代表性的邮件做同一件事,先比谁做得对,再比谁更快、更省内存。“榜单帮我们缩小范围,自己的样本帮助我们做决定。”
他对未来的想象不是每个人都去训一个大模型,而是每个业务都有一个只把一件事稳定做好的小模型——只做工单分类,或只从合同里提取几个固定字段。找到合适的模型之后,还可以继续量化、用业务数据微调,每一步都用真实样本检查效果有没有变差。“它也许规模不大,但把一件事稳定做好,就已经很有价值。”
(受访对象供图)
 网友评论