

科技日报记者 马爱平
日前,在2026 CCF全国高性能计算学术大会上,是石科技发布TokenFleet分布式调度框架。该框架面向大模型推理集群的请求路由、跨机房容量协同和混合负载治理,尝试通过提升有效Token(词元)产出,降低单位有效产出的服务成本,为国产算力规模化推理提供新的调度思路。
随着大模型应用从单点部署走向规模化服务,推理集群不仅要处理高并发请求,还要同时承载短对话、长上下文文档、离线批量任务等多种业务。不同租户对首Token响应、生成速度、完成时限等要求各不相同。若调度策略简单,容易出现部分实例排队、另一些容量闲置的情况,长请求与批量任务还可能挤压实时交互,造成超时、取消和重复计算,消耗资源却难以形成合格交付。
是石科技相关负责人介绍,TokenFleet分布式调度框架包含三项关键技术。TokenPilot负责同一模型池内的请求选点,既考虑KV缓存复用带来的计算节省,也评估排队等待代价。它会结合输入规模、输出预算、可复用前缀、队列状态、在途Token和预测延迟等因素筛选候选实例,避免请求集中涌向缓存命中率高的实例而产生新的等待。数据显示,在所测显卡集群与负载条件下,采用预测延迟路由后,P95(95分位)首Token延迟降低32.4%,P50(50分位)首Token延迟降低71.3%。
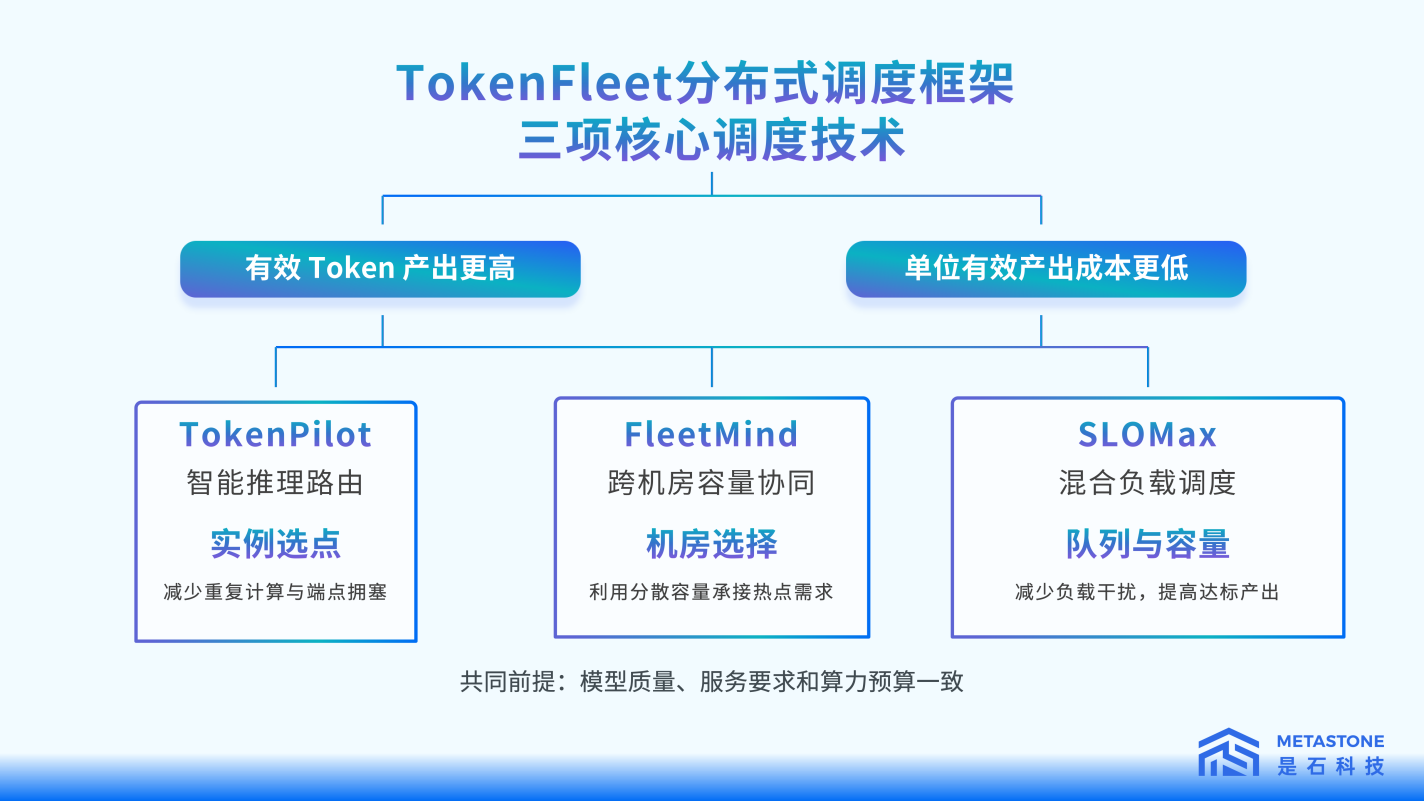
FleetMind面向跨机房容量协同。它汇聚各机房模型可用性、实时容量和网络状态,先选择执行机房,再由本地决策引擎选择具体实例。当热点机房出现排队时,系统会评估其他机房是否具备同版本模型就绪端点和服务余量,并在满足权限与数据地域约束的前提下,判断是否承接跨地域请求。
SLOMax负责混合负载治理。它依据输入长度、输出预算、任务类型和租户服务目标识别工作量,按等级准入、分池排队并协调容量,减少长容量压力和批量负载对交互请求的干扰。相关测算示例显示,采用流控协同调度后,达标输出吞吐量提高约29.4%。
上述负责人表示,未来,公司将围绕“国产Token优化工厂”持续打磨软件能力,推动通用、高频推理服务更经济、更稳定地运行。
(受访者供图)
 网友评论