

科技日报记者 付丽丽
继9月10日Day 0适配DeepSeek-V4.1-Flash后,云天励飞IFWA软件栈近日连续完成腾讯Hy4 preview与Qwen3.8-Flash-Next适配。相关验证在预硅仿真环境中开展,采用小规模真实权重切片作为验证载体。两次适配显示,面对模型架构快速演进,IFWA正从“重新开发”转向“能力复用”。
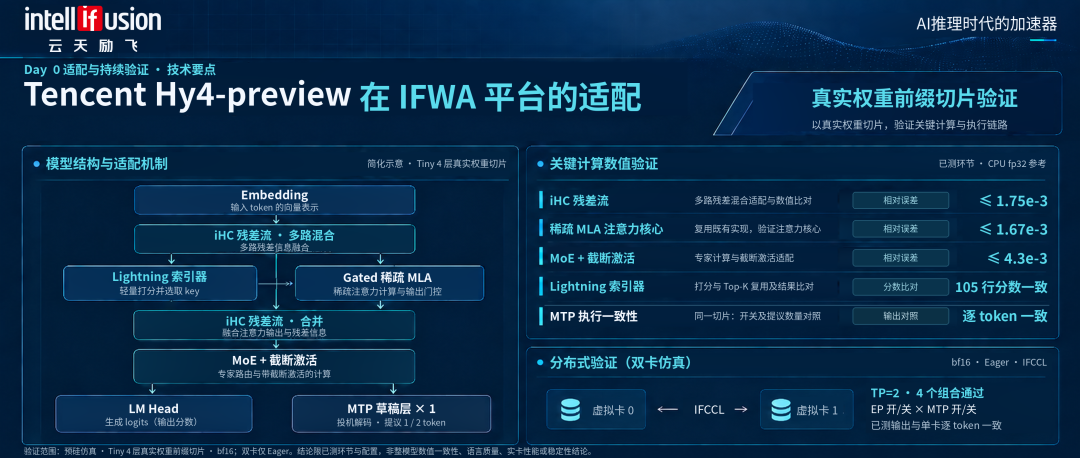
据介绍,本次适配的腾讯Hy4 preview与Qwen3.8-Flash-Next两大模型,均采用了前沿的创新架构设计,对软件栈的计算实现、推理调度、状态管理、层间交互能力提出了全新挑战。其中,Hy4 preview融合门控稀疏注意力、稀疏索引、iHC层间连接、混合专家(MoE)等多元创新机制;Qwen3.8-Flash-Next则在混合注意力、稀疏计算、PLE嵌入、n-gram嵌入及层间信息交互维度完成架构升级,两大模型的机制革新对传统模型适配方案提出严苛考验。
业内专家表示,两次适配体现出同一个趋势:模型在变,但底层软件能力不必每次推倒重来。随着通用算子、编译器和推理框架能力持续积累,软件栈可以更多承接模型变化,将研发资源集中到真正发生变化的计算机制和执行路径上。
然而,对于模型适配而言,完成端到端推理只是第一步。
此次两款模型适配均进一步使用真实权重切片开展关键计算环节的数值验证,以NVGPU BF16重算结果作为参考,对模型执行过程中的核心计算进行逐项比对。
这类验证让模型适配从“能不能跑起来”,进一步深入到“关键计算是否符合预期”,也为后续扩大模型规模和运行模式验证提供基础。
专家表示,大模型创新正在加速,模型架构的变化也正在从单点创新走向多种计算机制的组合。对于国产GPGPU平台而言,真正的竞争力不仅来自底层硬件,也来自能否持续、高效地承接快速演进的模型生态。
(受访单位供图)
 网友评论