

科技日报记者 李均
9月15日,无问芯穹联合清华大学、上海交通大学正式开源具身智能端侧推理引擎——APXInf,超前卡位具身智能从模型能力走向规模化落地的核心环节。APXInf支持RTX 4090、Jetson Orin、Jetson Thor等主流计算平台,覆盖从模型开发、效果验证到机器人本体部署的完整链路。它关注的不只是让具身模型在真实机器人上能够“跑起来”,更希望可以在有限资源下“跑得够快、够稳,也足够容易接入拓展和持续迭代”。
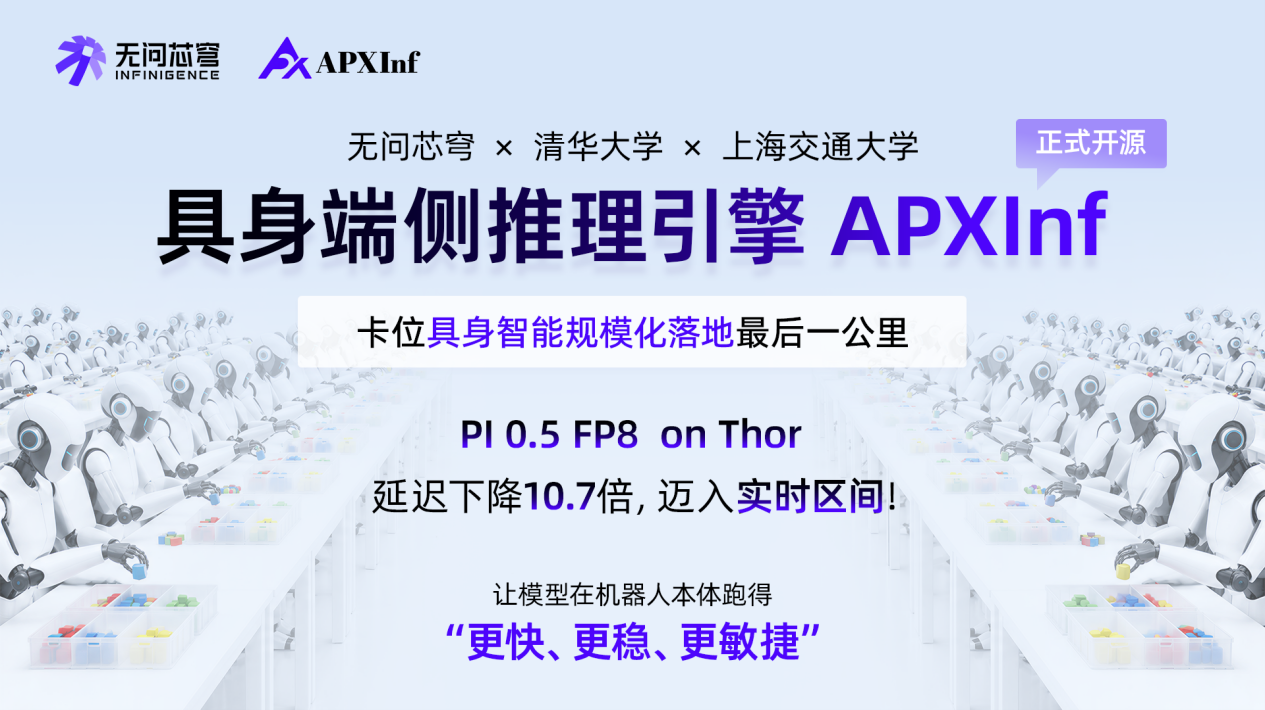
目前,APXInf已实现:PI 0.5 FP8在Jetson Thor上实现端到端推理延迟从278毫秒降低至26毫秒以内;在FP8下达到38.46赫兹推理频率,完全满足机器人多场景下实时控制对推理频率和响应延迟的要求。
通过针对机器人端侧场景的系统性推理优化,APXInf希望能进一步缩短具身智能从POC走向规模化落地的“最后一公里”。
其路线图为:支持更多的模型,VLA、VLM、世界模型等(已在适配中模型:Qwen、Groot);持续优化重点开源模型,扩充SOTA模型列表;极致的nvfp4性能优化;持续拓展国产化生态支持,支持国产芯片算力后端,支持国产机器人操作系统;适配AMD等行业主流芯片。
对具身智能而言,模型训练与本体推理从来不是彼此割裂的两个环节,而是同一条工程链路上的前后端。
不用讳言,今天的具身模型,已能够看懂环境、理解指令,并把看到的、听到的信息转化为机器人该怎么动的决策。但机器人最终还是要在物理世界里连续干活——从“眼睛看到”到“大脑决策”再到“手脚动起来”,整套流程都需在极短时间内完成闭环,这也是具身智能从Demo走向规模化应用绕不开的核心关卡。
对于云端的聊天机器人而言,几百毫秒延迟或许只是体验上的细微差异;但对需持续感知、连续决策和实时控制的机器人而言,几百毫秒带来的可能是动作迟滞、轨迹不连贯,甚至多次任务失败。
而当机器人走向规模化落地,还会叠加另一笔更加现实的“经济账”:算力成本、功耗及有限硬件资源的利用率。
因此,具身智能规模化落地需要的,并不是简单地把云端推理框架“搬”到机器人本体,而是一套真正面向端侧场景设计的推理系统:在有限的算力、功耗和成本约束下,兼顾小Batch、低延迟与持续实时交互,并充分挖掘硬件性能上限。
2025年9月,无问芯穹联合清华大学等团队开源了全球首个面向具身智能的大规模强化学习训练开源框架,而APX则是将RLinf的能力从模型训练与评测进一步延伸至机器人端侧推理与部署。
从训练到推理;从云端到本体;从“模型会做什么”到“机器人真正做出来”,APXInf正补上具身智能规模化落地关键一环。
(受访单位供图)
 网友评论